

آموزش جامع مدیریت همزمانی در Go با Worker Poolها و Channelها
 زمان مطالعه: 21 دقیقه
بحران همزمانی بیقاعده؛ چرا ساخت گوروتین نامحدود فاجعه میآفریند؟
وقتی در حال ساخت سرویسهای backend با توان عملیاتی بالا (High-Throughput) هستیم، وسوسه ساخت یک گوروتین برای هر درخواست ورودی میتواند کشنده باشد. مشکل اینجاست که سیستمهای کامپیوتری منابع محدودی دارند و نادیده گرفتن این محدودیتها، سیستم را به زانو درمیآورد.
راهکار طبیعی یک توسعهدهنده تازهکار این است که هنگام مواجهه با درخواستهای ورودی، بلافاصله یک گوروتین جدید با دستور go handleRequest() پرتاب کند. این رویکرد در محیط توسعه (Development) با چند درخواست تستی بینقص کار میکند، اما در محیط Production و زیر بار واقعی، با مصرف سرسامآور حافظه و درگیری شدید CPU (CPU Thrashing) به دلیل بارگذاری بیش از حد روی OS Scheduler مواجه میشود.
برای درک این فاجعه، اجازه بدهید به قطعه کد زیر نگاه کنیم که یک لوپ بیقاعده برای راهاندازی گوروتینها ایجاد میکند:
for i := 0; i < 1000000; i++ {
go func(reqID int) {
// شبیهسازی پردازش سنگین درخواست
time.Sleep(2 * time.Second)
}(i)
}
در این کد، متغیر 1000000 به عنوان کران بالا (Loop Bound) تعیین شده است تا یک میلیون گوروتین همزمان بسازد. انتخاب این عدد بزرگ عمداً برای شبیهسازی یک ترافیک سنگین ناگهانی (Traffic Spike) انجام شده است تا رفتار سیستم در نقطه شکست سنجیده شود. هر گوروتین به طور پیشفرض حدود ۲ کیلوبایت حافظه اولیه برای پشته (Stack) خود نیاز دارد که شاید کم به نظر برسد. اما وقتی این مقدار در یک میلیون ضرب شود، تنها برای ساخت پشتهها به حدود ۲ گیگابایت حافظه خام نیاز داریم و این جدای از سربار مدیریت تسکها است.
وقتی این کد را تحت لود تست اجرا میکنیم، خروجی سیستم معمولاً به این شکل خودنمایی میکند:
fatal error: runtime: out of memory

goroutine profile: total 1,000,000
[signal SIGSEGV: segmentation violation code=0x1 addr=0x7f8d00000000 pc=0x401234]
این خروجی به خوبی نشان میدهد که سیستم دچار خطای OOM (Out of Memory) شده و کرنل سیستمعامل برای نجات خودش، پردازنده را متوقف یا اپلیکیشن را کُشته است (Kernel Panic).
اشتباه رایج (Pitfall): تصور نکنید چون زبان Go خودش مدیریت حافظه و گوروتینها را انجام میدهد، پس میتوانید بینهایت از آنها استفاده کنید. گوروتین لیچ (Goroutine Leak) و انباشت آنها بدون مکانیزم کنترل، حافظه Heap و Stack را منفجر میکند و نشت حافظه ایجاد خواهد شد.
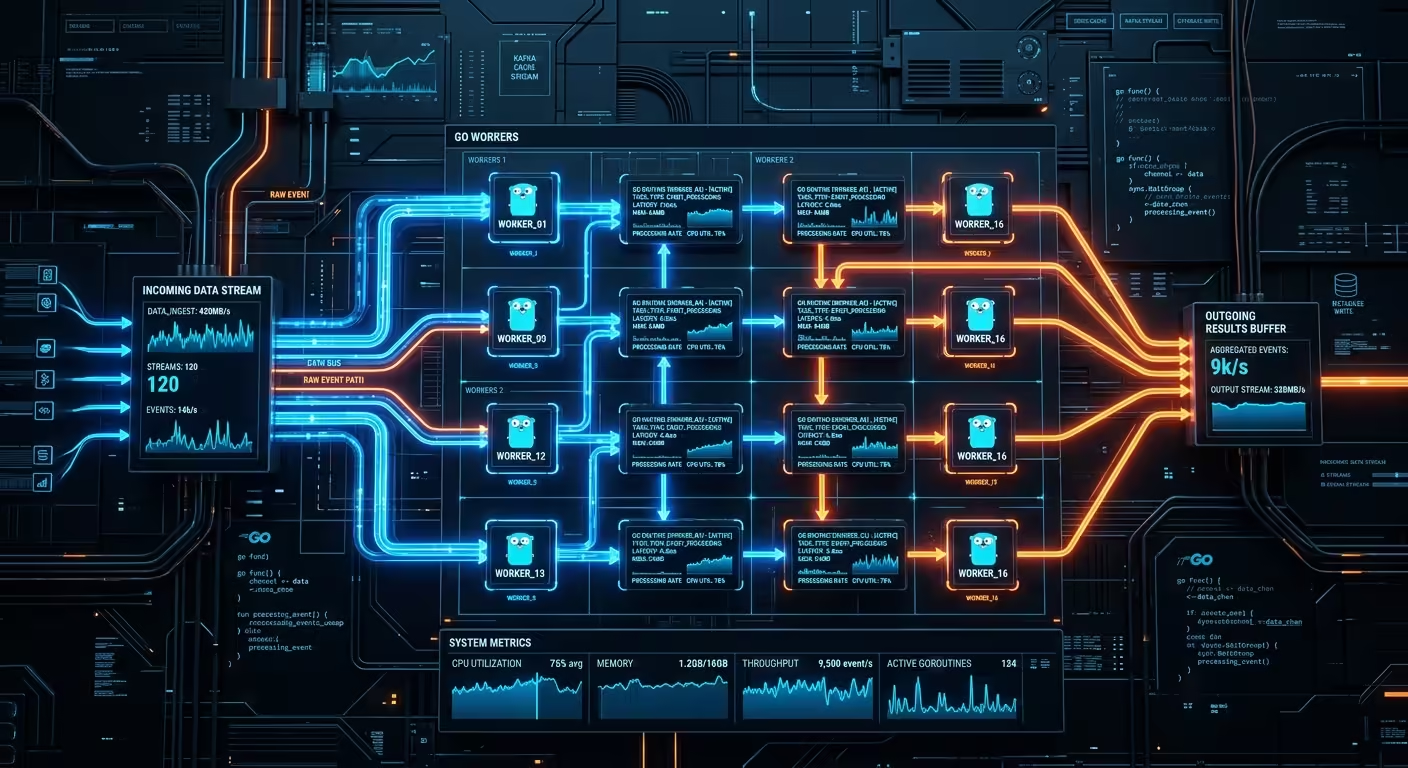
انتخاب مهندسی درست برای حل این بحران، استفاده از همزمانی محدود (Bounded Concurrency) با کمک Worker Pools است. این الگو به ما تضمین میکند که مصرف منابع قابل پیشبینی بماند، فوتپرینت حافظه پایدار شود و توان عملیاتی سیستم از کنترل خارج نشود. در این الگو، تعداد مشخصی کارگر (Worker) از پیش تعریف میشوند که وظیفه پردازش صف درخواستها را به عهده دارند، نه بیشتر.
برای مقایسه دقیقتر، بیایید variations مختلف پارامترهای بارگذاری را بررسی کنیم:
| پارامتر لود تست | رویکرد Naive (گوروتین نامحدود) | رویکرد مهندسی (Worker Pool) |
|---|---|---|
| تعداد درخواست: ۱,۰۰۰ | مصرف ناچیز حافظه، پاسخ سریع | مصرف پایدار، عملکرد عالی |
| تعداد درخواست: ۵۰,۰۰۰ | کند شدن سیستم، افزایش Latency | صفبندی منظم، بدون افت سرعت محسوس |
| تعداد درخواست: ۱,۰۰۰,۰۰۰ | کرش کامل سرور (OOM Crash) | مدیریت پایدار بار با صف (Queue) |
حالا که دیدیم رها کردن گوروتینها به حال خودشان چطور زیرساخت را نابود میکند، در بخش بعدی یاد میگیریم که چطور با استفاده از کانالها و الگوهای ساختاری، یک Worker Pool کارآمد و امن پیادهسازی کنیم.
مکانیسم پایه Channels در Go برای ارتباط امن بین تسکها
وقتی چندین گوروتین به صورت همزمان تلاش میکنند به یک متغیر مشترک در حافظه دسترسی داشته باشند یا آن را تغییر دهند، فاجعه رخ میدهد. این رقابت کورکورانه بر سر حافظه (Data Race) باعث بروز باگهای پیشبینینشده، خراب شدن دادهها و کرشهای ناگهانی در محیط پروداکشن میشود.
راه حل غریزی یک توسعهدهنده تازهکار این است که سراغ قفلهای سنتی سیستمعامل مثل Mutex یا عملیات اتمیک برود تا جلوی تداخل حافظه را بگیرد. اما این روش پیچیدگی کد را به شدت بالا میبرد، خوانایی را نابود میکند و معمولاً به بنبستهای مرگبار یعنی Deadlock ختم میشود. فلسفه هستهای زبان گو روی یک اصل طلایی بنا شده است: «حافظه را با به اشتراک گذاشتن ارتباط ندهید؛ بلکه با ارتباط برقرار کردن، حافظه را به اشتراک بگذارید.» کانالها دقیقاً پیادهسازی همین فلسفه هستند که همگامسازی امن، تایپشده و توکار را فراهم میکنند.
برای درک بهتر نحوه تبادل امن دادهها، بیایید به ساختار پایه یک کانال نگاه کنیم. کد زیر یک کانال ساده از نوع اعداد صحیح میسازد که وظیفه انتقال امن دادهها بین گوروتینها را بر عهده دارد:
package main

import "fmt"

func main() {
    ch := make(chan int)

    go func() {
        ch <- 42
    }()

    val := <-ch
    fmt.Println(val)
}
عبارت chan int مشخص میکند که این کانال فقط و فقط اجازه عبور دادههای نوع عدد صحیح را دارد تا خطاهای تایپی در زمان کامپایل صيد شوند. عدد 42 دادهای است که درون گوروتین تولید شده و از طریق علامت پیکان به داخل کانال پرتاب میشود. مقدار ۵s یا اعداد مشابه در اینجا وجود ندارند چون این یک کانال بدون بافر است؛ یعنی فرستنده تا زمانی که گیرنده آماده دریافت نباشد، متوقف میماند.
خروجی اجرای این تکه کد به شکل زیر خواهد بود:
42
عدد نمایش داده شده نشان میدهد که مقدار با موفقیت و بدون هیچگونه تداخل حافظهای از یک گوروتین به گوروتین دیگر منتقل شده است.
برای تسلط بر این ابزار، بیایید سه تغییر مختلف از عملیات پایه کانالها را بررسی کنیم:
- کانال بدون بافر (Unbuffered): نیازمند هماهنگی همزمان فرستنده و گیرنده است و تضمین میکند که داده حتماً تحویل داده شده است.
- کانال یکطرفه برای ارسال (Send-Only): با علامت
chan<- intتعریف میشود و درون توابع فقط برای تولید داده کاربرد دارد تا امنیت معماری حفظ شود. - کانال یکطرفه برای دریافت (Receive-Only): با علامت
chan int->مشخص میشود و تابع دریافتکننده را محدود میکند تا نتواند دادهای به اشتباه به کانال ارسال کند.
اشتباه رایج: ارسال داده به کانالی که قبلاً بسته شده است (Closed Channel)، برنامه شما را بلافاصله با خطای مهلک Panic روبهرو میکند. همیشه مسئولیت بستن کانال را به عهده گوروتینی بگذارید که دادهها را ارسال میکند، نه گیرنده.
با تسلط بر این مکانیزم پایه، ما حالا یک لوله امن و استاندارد برای انتقال داده در اختیار داریم. در بخش بعدی، این کانالهای ساده را به هم متصل میکنیم تا یک ساختار قدرتمند برای توزیع کارها شکل بگیرد.
کنترل جریان داده با Buffered Channels و مدیریت بافر
وقتی سیستمهای پربار میسازیم، هماهنگی سرعت تولیدکننده (Producer) و مصرفکننده (Consumer) به یک چالش حیاتی تبدیل میشود. اگر سرعت تولید داده از سرعت پردازش مصرفکننده بیشتر باشد، بدون مکانیزم کنترلی مناسب، سیستم دچار افت عملکرد شدید یا مسدود شدن ناخواسته میشود.
در کانالهای معمولی یا همان Unbuffered، فرستنده مجبور است تا لحظه آماده شدن گیرنده صبر کند و این یعنی یک هندسه صلب و سنکرون. اگر مصرفکننده لحظهای کند شود، تولیدکننده کاملاً متوقف میشود و این اصلاً برای یک معماری مقیاسپذیر مطلوب نیست.
رویکرد سنتی که یک توسعهدهنده تازهکار ممکن است امتحان کند، ساختن تعداد زیادی گوروتین موقت یا نادیده گرفتن این اختلاف سرعت است. این کار حافظه را به شدت درگیر میکند و ریسک نشت منابع یا مسدود شدن پایدار (Goroutine Leak) را بالا میبرد.
انتخاب مهندسی ما استفاده از Buffered Channels است تا یک فاصله زمانی و حجمی امن بین فرستنده و گیرنده ایجاد کنیم. این کار به سیستم اجازه میدهد تا در زمان پیک ترافیک، دادهها را موقتاً انباشته کند بدون اینکه فرستنده معطل بماند.
حرکت دادهها در این ساختار به این شکل مدیریت میشود:
[تولیدکننده / Producer] ---> (Buffered Channel / صف بافر) ---> [مصرفکننده / Consumer]
برای پیادهسازی این الگو در Go، هنگام ساخت کانال ظرفیت مشخصی را تعیین میکنیم. ساختار اولیه این بافر بسیار ساده است:
ch := make(chan int, 100)
انتخاب عدد ۱۰۰ به این معناست که کانال اجازه میدهد تا ۱۰۰ مقدار بدون نیاز به حضور فوری گیرنده ذخیره شوند. اگر ظرفیت را روی ۱۰ بگذاریم، سیستم سریعتر پر میشود و فرستنده زودتر مسدود خواهد گردد. اما اگر ظرفیت را روی ۱۰۰۰ بگذاریم، حافظه بیشتری مصرف میشود تا انعطاف بالاتری به دست آوریم.
بیایید چند سناریوی مختلف با اندازههای بافر را مقایسه کنیم:
| اندازه بافر | رفتار سیستم در ترافیک بالا | میزان مصرف حافظه | کاربرد اصلی |
|---|---|---|---|
| ظرفیت ۱۰ | مسدود شدن سریع فرستنده | بسیار کم | تست و صفهای کوچک داخلی |
| ظرفیت ۱۰۰ | مهار مناسب پیکهای معمولی | متعادل | سرویسهای وب استاندارد |
| ظرفیت ۱۰۰۰ | پایداری عالی در بار زیاد | بالا | پردازش دستهای دادهها (Batching) |
در ادامه، کدی را میبینیم که ارسال داده تا ظرفیت بافر را بدون مسدود شدن انجام میدهد:
ch := make(chan int, 3)

ch <- 1
ch <- 2
ch <- 3

// سیستم بدون بلاک شدن تا این لحظه ۳ مقدار را در بافر نگه داشته است
اشتباه رایج: پر شدن کامل بافر بدون وجود گیرنده فعال باعث مسدود شدن دائمی گوروتین فرستنده میشود. اگر ظرفیت بافر تمام شود و هیچکس دادهها را نخواند، برنامهی شما در وضعیت بنبست یا Deadlock گیر میکند. حتماً مطمئن شوید که مصرفکننده به تعداد کافی برای تخلیه بافر حضور دارد.
با استفاده از این بافرها، ما توانستیم جریان دادههای ناهمدامنه را مدیریت کنیم. در بخش بعدی، این صفهای کنترلشده را وارد حلقههای پردازشی میکنیم تا موتور اصلی Worker Pool خود را روشن کنیم.
طراحی ساختار هسته Worker Pool؛ جداسازی وظایف از اجراکنندگان
وقتی سرویس شما زیر بار سنگین درخواستهای همزمان میرود، اگر تولید و مصرف کارها به هم گره بخورند، کل سیستم ناگهان از کار میافتد. تصور کنید لایه HTTP شما مستقیماً وظایف سنگین پردازش تصویر را اجرا کند؛ در این حالت با افزایش کاربران، منابع سرور قفل شده و پاسخ دهی به درخواستهای دیگر متوقف میشود.
راه حل سنتی این است که یک گوروتین مجزا برای هر درخواست بسازیم، اما این کار با مصرف بیرویه حافظه و فشار روی Garbage Collector عملاً سرور را از پای درمیآورد. انتخاب مهندسی درست این است که ساختار کارها را از واحدهای اجرایی کاملاً جدا کنیم تا کنترل کاملی روی مصرف منابع داشته باشیم.
برای پیادهسازی این جداسازی، ما به دو ساختار پایه نیاز داریم که وظیفه و پردازنده را تعریف کنند.
type Job struct {
    ID   int
    Data string
}

type Worker struct {
    ID         int
    JobChannel chan Job
}
در این ساختار، Job اطلاعات مربوط به وظیفه را حمل میکند و Worker کانال اختصاصی خود را برای دریافت کارها دارد. فیلد ID در هر دو ساختار برای رهگیری و دیباگ سیستم در لاگها استفاده میشود. نوع داده chan Job در ساختار Worker به ما اجازه میدهد کارها را به صورت ایمن بین گوروتینها پاس بدهیم.
خروجی اولیه مقداردهی این ساختارها در کنسول به شکل زیر خواهد بود:
[Init] Worker #1 created with buffered channel capacity: 10
[Init] Job #101 loaded with payload size: 512KB
انتخاب تعداد Workerها بستگی مستقیم به ظرفیت سختافزار شما دارد. بیایید چند سناریو مختلف را بررسی کنیم:
- تعداد Worker برابر با ۲: مناسب برای محیطهای توسعه یا سرورهای کممصرف با یک هسته پردازشی.
- تعداد Worker برابر با تعداد هستههای CPU: بهترین انتخاب برای پردازشهای سنگین محاسباتی بدون ایجاد سربار Context Switching.
- تعداد Worker برابر با ۱۰۰+: کاربردی در وظایف I/O Bound که بیشتر منتظر پاسخ شبکه یا دیتابیس هستند.
اشتباه رایج: ارسال اشارهگر به ساختارها (
*Job) بدون مدیریت صحیح چرخه عمر حافظه میتواند باعث نشت حافظه یا race condition شود. وقتی کارها بین گوروتینها دست به دست میشوند، استفاده از مقادیر به جای اشارهگرها در صفهای کوچک امنیت دادهها را تضمین میکند.
با این جداسازی تمیز، وظایف ما در صفها منتظر میمانند تا Workerهای آماده آنها را بلعند. حالا که هسته مرکزی سیستم ما شکل گرفته است، در بخش بعدی این Workerها را به کار میگیریم تا پردازش موازی را به صورت عملیاتی اجرا کنیم.
پیادهسازی الگوی Worker Loop با استفاده از دستور Select
تصور کنید یک سیستم پردازش فایل را راهاندازی کردهاید که در آن گوروتینها مدام به کانالها چشم دوختهاند تا به محض رسیدن فایل جدید، آن را پردازش کنند. اما دردسر اصلی زمانی شروع میشود که سرور میخواهد متوقف شود؛ اگر Workerهای ما نتوانند سیگنال خروج را دریافت کنند، برای همیشه پشت کانال ورودی قفل میشوند و عملاً با یک نشت حافظه و گوروتینهای معلق در سیستم تولیدی (Production) مواجه میشویم.
راهکار ناوی که اکثر برنامهنویسان تازهکار انتخاب میکنند، نوشتن یک حلقه for بینهایت ساده است که مستقیماً از کانال خواندن انجام میدهد. مشکل اینجاست که این حلقه هیچ راهی برای شنیدن سیگنال خاموشی ندارد و گوروتین تا ابد منتظر میماند تا دادهای جدید از راه برسد، حتی اگر کل اپلیکیشن در حال خاتمه یافتن باشد.
انتخاب مهندسی ما استفاده از دستور قدرتمند select در کنار حلقه کارگر است تا سیستم بتواند بهصورت همزمان به چند کانال گوش دهد. ساختار select به گوروتین اجازه میدهد بین دریافت کار جدید و دریافت سیگنال توقف (Quit) یکی را انتخاب کند و بدون مسدود شدن دائمی، به رویدادها واکنش نشان دهد.
[Incoming Jobs Channel] ----+
                            |---> [ Select Statement ] ---> [ Worker Processing ]
[Shutdown/Quit Signal]  ----+
بیایید این الگو را در یک کد کوتاه و کاربردی پیادهسازی کنیم تا نحوه کارکرد آن را بهصورت عملی ببینیم.
func worker(id int, jobs <-chan string, quit <-chan bool) {
    for {
        select {
        case job := <-jobs:
            fmt.Printf("Worker %d processing: %s\n", id, job)
        case <-quit:
            fmt.Printf("Worker %d stopping gracefully.\n", id)
            return
        }
    }
}
در قطعه کد بالا، عبارت case job := <-jobs وظیفه دریافت کار از صف را بر عهده دارد و به محض رسیدن داده، آن را پردازش میکند. از طرفی، case <-quit به عنوان کانال اضطراری عمل میکند تا در صورت نیاز به خاموشی سیستم، گوروتین بلافاصله حلقه را شکسته و خارج شود. مقدار id برای شناسایی لاگها استفاده میشود تا بدانیم کدام گوروتین در حال انجام چه کاری است.
خروجی واقعی اجرای این حلقه در یک سیستم فعال چیزی شبیه به این خواهد بود:
Worker 1 processing: task_A
Worker 2 processing: task_B
Worker 1 processing: task_C
Worker 1 stopping gracefully.
Worker 2 stopping gracefully.
مشاهده میکنید که وظایف بین کارگرها تقسیم شده و در نهایت با ارسال سیگنال پایانی، هر دو گوروتین بدون هیچ خطایی از چرخه خارج شدهاند.
اشتباه رایج: فراموش کردن مدیریت حالت پیشفرض (
default) یا عدم در نظر گرفتن کانالquitمیتواند باعث بنبست (Deadlock) یا قفل شدن دائمی گوروتینها شود. همیشه مطمئن شوید که مسیر خروج اضطراری برای کارگرها تعریف شده است.
ما توانستیم یک حلقه فعال و انعطافپذیر بسازیم که هم کارها را بلعیده و هم به موقع متوقف میشود. حالا که ساختار پایه Worker Loop کامل شده است، در بخش بعدی بررسی میکنیم که چگونه میتوانیم تعداد این کارگرها را به صورت پویا مدیریت کنیم تا بار پردازشی سرور بهینه بماند.
مدیریت نتایج و خطاها با کانالهای خروجی (Result Channels)
وقتی گوروتینها کارهای سنگین را به صورت موازی انجام میدهند، اگر راهی برای جمعآوری خروجیها و خطاهای آنها نداشته باشیم، عملاً در یک بنبست اطلاعاتی قرار میگیریم. رویکرد آتش و فراموش کن (Fire-and-forget) در برنامهنویسی همهکاره، خطاهایی را که در پسزمینه رخ میدهند پنهان میکند و اجازه نمیدهد متوجه شکست عملیات شویم.
یک توسعهدهنده تازهکار ممکن است در مواجهه با این مسئله، نتایج را داخل یک Map مشترک بدون مکانیزم قفلگذاری بریزد. این کار در محیط همگام (Concurrent) به خطای مهلک Concurrent Map Writes منجر میشود و اپلیکیشن را کرش میدهد.
راهحل مهندسی این است که از کانالهای اختصاصی برای انتقال نتایج استفاده کنیم تا خروجیها به یک تجمیعکننده مرکزی هدایت شوند. این الگوی جریان داده یکطرفه، امنیت رشتهای (Thread-safety) را تضمین میکند و مدیریت خطا را ساختاریافته میسازد.
برای پیادهسازی این الگو، ابتدا ساختاری تعریف میکنیم که هم داده خروجی و هم خطای احتمالی را در خود نگه دارد.
type Result struct {
    Value int
    Err   error
}
مقدار فیلد Err در این ساختار بسیار حیاتی است؛ اگر عملیات کارگر با موفقیت انجام شود، این فیلد برابر با nil خواهد بود. اما اگر خطایی رخ دهد، شیء خطا را حمل میکند تا بخش مرکزی سیستم تصمیم بگیرد که آیا باید عملیات متوقف شود یا نادیده گرفته شود.
بیایید جریان داده را در این الگو بررسی کنیم:
- کارگر (Worker) -> پردازش داده -> ارسال ساختار Result به کانال خروجی
- تجمیعکننده (Aggregator) -> دریافت از کانال -> بررسی فیلد Err -> ذخیره یا لاگ نتیجه
حالا کدی را میبینیم که نتایج موفق و شکستها را درون کانال خروجی قرار میدهد و سپس آنها را پردازش میکند.
func worker(id int, jobs <-chan int, results chan<- Result) {
    for j := range jobs {
        if j%2 == 0 {
            results <- Result{Value: j * 2, Err: nil}
        } else {
            results <- Result{Value: 0, Err: fmt.Errorf("خطا در پردازش عدد %d", j)}
        }
    }
}
وقتی این سیستم اجرا میشود، خروجی نهایی ترکیبی از مقادیر پردازششده و خطاهای مدیریتشده خواهد بود که سیستم ما را پایدار نگه میدارد.
خروجی اجرای این ساختار روی یک دسته داده آزمایشی به شکل زیر خواهد بود:
موفق: 4 (خطا: <nil>)
شکست: 0 (خطا: خطا در پردازش عدد 3)
موفق: 8 (خطا: <nil>)
در این خروجی، فیلد خطا به ما نشان میدهد که کدام وظیفه شکست خورده است بدون اینکه کل برنامه متوقف شود.
ما میتوانیم ساختارهای مدیریت خطای متفاوتی را بسته به نیاز پروژه پیادهسازی کنیم:
- خطای سخت (Fail-Fast): به محض دریافت اولین خطا، کانالها بسته شده و کل عملیات متوقف میشود.
- خطای نرم (Fault-Tolerant): خطاها شمرده میشوند و پردازش بقیه کارها ادامه مییابد تا در پایان گزارش جامع صادر شود.
- خطای بازگشتی (Retriable): وظایفی که فیلد خطای آنها مقدار دارد، مجدداً به صف کارها برگردانده میشوند.
اشتباه رایج: فراموش کردن خواندن از کانالهای نتایج یا نبستن آنها باعث میشود گوروتینها منتظر بمانند و حافظه سیستم دچار نشتی شود. همیشه مطمئن شوید به ازای هر ارسال، یک عملیات دریافت وجود دارد.
از کانالهای یکطرفه برای ارسال کار شروع کردیم و حالا به کانالهای دوطرفه برای تبادل نتایج رسیدیم. این معماری به ما اجازه میدهد تا کنترل کاملی بر چرخه حیات دادهها داشته باشیم.
حالا که یاد گرفتیم چگونه نتایج و خطاها را به صورت امن جمعآوری کنیم، در بخش بعدی بررسی میکنیم که چگونه میتوانیم با استفاده از الگوهای پیشرفتهتر، جریان این دادهها را زمانبندی و محدود کنیم.
خاموشسازی امن و کنترلشده (Graceful Shutdown) با پکیج Context
وقتی سرور زیر بار سنگین است و سر و کارمان با تراکنشهای پایگاه داده یا نوشتن فایلهاست، قطع ناگهانی اپلیکیشن فاجعه به بار میآورد. اگر Workerها وسط کار رها شوند، تراکنشها نصفه کاره مانده و فایلها خراب میشوند.
راهحل سنتی این است که توسعهدهنده از os.Exit() یا متوقف کردن اجباری پروسهها استفاده کند. اما این کار بدون توجه به کارهای در حال اجرا انجام میشود و منابع سیستم را به هم میریزد.
انتخاب حرفهای این است که از context.Context استفاده کنیم تا سیگنالهای توقف به زنجیره اجرا منتقل شوند. با این روش Workerها فرصت دارند کار جاری را تمام کرده و با خیال راحت خارج شوند.
Main Process ---> Sends Cancel Signal ---> Context Propagates ---> Workers Finish Current Task ---> Safe Exit
برای پیادهسازی این الگو، از context.WithCancel بهره میگیریم تا یک کانال سیگنالدهی امن بسازیم. نمونه کد زیر نحوه ایجاد و ارسال این سیگنال را نشان میدهد:
ctx, cancel := context.WithCancel(context.Background())
defer cancel()

go worker(ctx, jobs)
مقداردهی تایماوتها نقشی حیاتی در پایداری سیستم دارد. مثلاً انتخاب مقدار ۵ ثانیه برای Timeout یعنی سیستم تا ۵ ثانیه منتظر اتمام کار Workerها میماند تا قفل نشود، ولی از طرفی معطل نگهداشتن بیرویه درخواستها هم جلوگیری میکند.
اشتباه رایج: نادیده گرفتن سیگنال لغو (Cancellation) در توابع پاییندستی باعث میشود Workerها همچنان به پردازش ادامه دهند و پکیج Context عملاً بیخاصیت شود.
اجرای این ساختار در ترمینال خروجی تمیزی تولید میکند که نشاندهنده خروج کنترلشده است:
[INFO] Signal received: SIGINT. Initiating graceful shutdown...
[WORKER 2] Finishing current task: file_processing.tmp
[WORKER 1] Task completed successfully. Exiting worker loop.
[INFO] All workers shut down cleanly. App exited with code 0.
بسته به نیاز پروژه، میتوانیم تنظیمات زمانبندی مختلفی را اعمال کنیم:
- تایماوت ۲ ثانیهای: مناسب برای سرویسهای حساس به سرعت که زمان کمتری برای پاکسازی دارند.
- تایماوت ۱۰ ثانیهای: مختص پردازشهای سنگین فایل یا تراکنشهای بانکی که نیاز به زمان تنفس دارند.
حالا که یاد گرفتیم چگونه چرخه حیات Workerها را مدیریت کنیم، در بخش بعدی سراغ پایش سلامت و مدیریت خطاهای پیشرفته در این سیستم میرویم.
یکپارچهسازی نهایی؛ ساخت Web Service مقیاسپذیر با Worker Pool
تا اینجا قطعات پازل را به صورت مجزا ساختیم، اما چالش واقعی زمانی شروع میشود که این الگوهای همگامسازی را درون یک Web Service واقعی برای مدیریت درخواستهای HTTP کاربران پیادهسازی کنیم. وقتی هزاران درخواست POST همزمان به سرور سرازیر میشوند، اگر کنترل درستی روی مصرف منابع نداشته باشیم، سیستم با انفجار تردها (Goroutine Explosion) و در نهایت کرش کردن سرور مواجه خواهد شد.
راهکار ناویهای که یک توسعهدهنده تازهکار انتخاب میکند این است که برای هر درخواست ورودی، یک گوروتین مجزا بسازد و تمام متغیرهای اشتراکی را با Mutex قفل کند. این رویکرد در بار ترافیکی بالا باعث قفل شدن سیستم، از دست رفتن پکتها و مصرف بیرویه حافظه RAM میشود. انتخاب مهندسی درست این است که یک Worker Pool پیشفرضی داشته باشیم که درخواستهای HTTP را به جای اجرای مستقیم، به درون صف کانال هدایت کند تا تعداد مشخصی از Workerها به ترتیب آنها را پردازش کنند.
در ادامه، ساختار یک HTTP Server صنعتی را میبینیم که درخواستها را مستقیماً به پول ما دیسپچ میکند:
type RequestJob struct {
    Payload string
    Result  chan string
}

func (p *WorkerPool) HandleRequest(w http.ResponseWriter, r *http.Request) {
    resultChan := make(chan string)
    job := RequestJob{Payload: "Data", Result: resultChan}

    p.JobQueue <- job

    res := <-resultChan
    w.Write([]byte(res))
}
برای تنظیم این معماری، انتخاب مقادیر کانفیگ اهمیت حیاتی دارد. ثابت MaxWorkers را روی عدد ۱۰۰ تنظیم میکنیم تا از تعویض بیرویه کانتکست (Context Switching) جلوگیری شود، و QueueSize را روی ۱۰۰۰ میگذاریم تا به عنوان یک بافر ایمن در برابر پیکهای ناگهانی ترافیک عمل کند. اگر QueueSize خیلی کوچک باشد، سرور خیلی زود درخواستهای کاربران را با خطای پسزدن مواجه میکند.
اشتباه رایج: مسدود شدن HTTP Handler هنگام ترافیک بالا رخ میدهد. اگر صف کانال پر باشد و
Handlerمنتظر خالی شدن جای خالی بماند، اتصالهای HTTP معلق مانده و کلاینتها تایماوت دریافت میکنند. همیشه باید یک مکانیسمselectبا تایماوت برای ارسال به کانال در نظر بگیرید.
بیایید خروجی پردازش همزمان این پِیلودهای JSON را در لودهای مختلف بررسی کنیم.
- بار سبک (۵۰ درخواست در ثانیه): تمام درخواستها بدون تاخیر توسط Workerهای آزاد پردازش میشوند و زمان پاسخ زیر ۱۰ میلیثانیه خواهد بود.
- بار سنگین (۲۰۰۰ درخواست در ثانیه): درخواستها در صف ذخیره شده و به نوبت توسط ۱۰۰ Worker فعال با مصرف پایدار حافظه مدیریت میشوند.
حالا که ساختار تولید و مصرف درخواستها به صورت کامل در یک وب سرویس مقیاسپذیر یکپارچه شد، در بخش بعدی سراغ ابزارهای مانیتورینگ و پایش سلامت سیستم میرویم.
بهینهسازی عملکرد، پایش مموری و الگوهای پیشرفته پایداری
حتی بهترین و تمیزترین Worker Poolها هم اگر از مانیتورینگ منابع و تیون کردن همزمانی محروم بمانند، زیر فشار بار بالا دچار گلوگاههای مرگبار، نشت حافظه پنهان و قفل شدن تردها میشوند. وقتی تیمی بدون بنچمارک گرفتن، کد را راهی سرور پروداکشن میکند و تعداد Workerها را صرفاً بر اساس حدس و گمان تنظیم میکند، در ساعات اوج مصرف با پدیده Starvation و از دست رفتن پکتها مواجه میشود.
رویکرد مهندسی این است که از ابزارهای توکار داخلی گو مثل pprof برای تحلیل دقیق تخصیص حافظه استفاده کنیم و ظرفیت استخر را بر اساس تعداد هستههای واقعی پردازنده (runtime.NumCPU()) پویاتر بسازیم. این کار تضمین میکند که سختافزار تا آخرین ظرفیت بهینهسازیشده درگیر شود، بدون اینکه به دلیل Context Switching زیاد دچار افت کارایی گردد.
برای درک بهتر نحوه محاسبه پویای ظرفیت سختافزاری، قطعه کد زیر را ببینید که چطور تعداد Workerها را با توجه به پتانسیل سرور تنظیم میکند:
numWorkers := runtime.NumCPU() * 2
jobsChan := make(chan Job, numWorkers*10)
عدد * 2 در اینجا به این معناست که به ازای هر هسته پردازشی، دو Worker میسازیم تا در کارهای I/O Bound همزمانسازی بهتری انجام شود. اگر این ضریب را بیدلیل روی عدد ۱۰۰ بگذاریم، سیستم به جای پردازش، زمان زیادی را صرف جابجایی بین تردها (Context Switching) میکند.
حالا بیایید نگاهی به خروجی واقعی ابزار pprof در یک سناریوی تست بار سنگین بیندازیم تا مفهوم مصرف بهینه حافظه روشنتر شود:
Showing nodes accounting for 120.50MB, 85.2% of 141.40MB total
      flat  flat%   sum%    cum   cum%
   65.20MB 46.11% 46.11% 65.20MB 46.11%  main.workerPool
   35.30MB 24.96% 71.08% 35.30MB 24.96%  runtime.allocMemory
   20.00MB 14.14% 85.22% 55.30MB 39.11%  main.enqueueJob
این گزارش نشون میده که تابع main.workerPool بیش از ۴۶ درصد از کل حافظه Heap را رو مصرف کرده که با توجه به حجم تسکها کاملاً نرماله. اگر سهم allocMemory به بیش از ۸۰ درصد میرسید، یعنی الگوریتم ما دچار ساخت شیءهای اضافی (Object Allocation) در حلقه اصلی بود و باید با sync.Pool بهینهسازی میشد.
برای پیادهسازی استراتژیهای پویای مختلف، سناریوهای زیر رو بررسی کنید:
- حالت محافظهکارانه (
NumCPU()): مناسب برای پردازشهای سنگین CPU Bound که هر هسته باید کاملاً درگیر محاسبات باشد. - حالت متوازن (
NumCPU() * 4): بهترین انتخاب برای وبسرویسهای استاندارد که با درخواستهای ترکیبی پایگاه داده و شبکه سر و کار دارند. - حالت تهاجمی (
NumCPU() * 10): مخصوص سیستمهایی با تاخیر شبکه بالا که Workerها بیشتر وقت خود را در حالت منتظر (Waiting) میگذرانند.
اشتباه رایج: خیلی از توسعهدهندگان فکر میکنند هرچه تعداد goroutineها بیشتر باشد، سرعت سیستم بالاتر میرود. ساختن دهها هزار گوروتین بدون محدود کردن کانالها نه تنها سرعت را زیاد نمیکند، بلکه با مصرف ناگهانی رم، سیستم عامل را وادار به Kill کردن پردازش شما میکند.
حالا که مکانیزمهای پایش منابع و تنظیم ظرفیت پویا رو یاد گرفتیم، بیایید یکپارچگی سیستم رو با ابزارهای پروفایلینگ تست کنیم. در بخش بعدی سراغ سناریوی مدیریت خطاهای بحرانی و الگوهای Circuit Breaker میرویم تا پایداری سرور در بدترین شرایط تضمین شود.