

آموزش Covering Indexes در PostgreSQL — از پایه تا پیادهسازی
 زمان مطالعه: 21 دقیقه
مقدمهای بر بحران I/O در دیتابیسهای حجیم و لزوم بهینهسازی بازیابی داده
وقتی تعداد رکوردهای جدول در دیتابیس به چند میلیون میرسد، کوئریهایی که در محیط توسعه بسیار سریع اجرا میشدند، ناگهان سرور را با بحران خواندن دیسک یا همان I/O Bottleneck مواجه میکنند. این مشکل زمانی خود را نشان میدهد که سیستم به جای استفاده از حافظه رم، مجبور است اطلاعات را مداوم از روی دیسکهای سخت یا حتی SSDهای زیر بار بخواند.
راهکار یک توسعهدهنده جونیور در مواجهه با این کندی، ساختن ایندکسهای استاندارد B-Tree روی ستونهای شرطی (مثل WHERE) است. اما وقتی سیستم همچنان کند است، این سوال پیش میآید که چرا با وجود ایندکس، کوئریها همچنان باعث خواندن سنگین جدول یا اصطلاحاً Heap Fetches میشوند؟
علت این است که ایندکس معمولی تنها آدرس رکورد را در جدول پیدا میکند و دیتابیس برای برداشتن ستونهای موجود در دستور SELECT، باید یک قدم اضافهتر بردارد و به خود جدول مراجعه کند. این رفتوبرگشت مداوم بین ایندکس و جداول اصلی، منابع سختافزاری را به شدت درگیر میکند.
انتخاب مهندسی برای حل این چالش، استفاده از Covering Indexes یا همان ایندکسهای پوششدهنده است که با تکنیک INCLUDE ستونهای اضافی را مستقیماً در گرههای برگی (Leaf Nodes) ایندکس قرار میدهند. با این روش، دیتابیس تمام دادههای مورد نیاز کوئری را یکجا از خود ایندکس میخواند و نیازی به مراجعه به جدول اصلی نخواهد داشت.
[درخواست کوئری] ---> [ایندکس B-Tree + ستونهای INCLUDE] ---> [بازگرداندن مستقیم نتیجه]
|
+--- (بدون نیاز به مراجعه به جدول اصلی یا Heap Fetch)
با این حال، این روش بدون هزینه نیست و trade-off خودش را دارد؛ افزایش تعداد ستونها در ایندکس باعث حجیمتر شدن خود ایندکس و کندتر شدن عملیات نوشتن (INSERT/UPDATE) میشود. بنابراین نباید کورکورانه تمام ستونهای جدول را در ایندکس پوششدهنده قرار داد.
اشتباه رایج: تصور اینکه ساختن یک ایندکس بزرگ با ستونهای فراوان همیشه سرعت سیستم را بالا میبرد، یکی از تلههای رایج است. هرچقدر حجم ایندکس بیشتر شود، فضای کش رم کمتر شده و عملیات نوشتن در دیتابیس هزینهبرتر خواهد شد.
در ادامه این آموزش، نحوه پیادهسازی دقیق این ساختارها را در PostgreSQL بررسی خواهیم کرد تا بتوانید خواندن اطلاعات را در مقیاسهای کلان بهینهسازی کنید.
آناتومی ساختار ایندکس در PostgreSQL و مفهوم Index Tuple
تصور کنید برای پیدا کردن شماره تلفن یک شخص در دفترچه تلفنی که هیچ ترتیبی ندارد، مجبور باشید تکتک صفحات را ورق بزنید؛ این دقیقا همان هزینهای است که پایگاه داده بدون ایندکس مناسب پرداخت میکند. وقتی کوئریهای ما روی جدولهای میلیونی بدون درک ساختار داخلی ایندکس اجرا میشوند، سیستم ناچار به انجام Sequential Scan یا همان بررسی کل دیسک میشود که سرعت پاسخدهی را به شدت افت میدهد. راهکار ابتدایی یک توسعهدهندهای که با ساختار داخلی دیتابیس آشنا نیست، ساختن ایندکس روی تمام ستونهای پرکاربرد است که این رویکرد به مرور زمان فضای ذخیرهسازی را منفجر کرده و حافظه کش رم را با دادههای تکراری و غیرضروری پر میکند. انتخاب مهندسی صحیح این است که بدانیم دیتابیس دادهها را چطور درون گرههای ساختار درختی ذخیره میکند و یک Index Tuple دقیقاً چه اجزایی دارد.
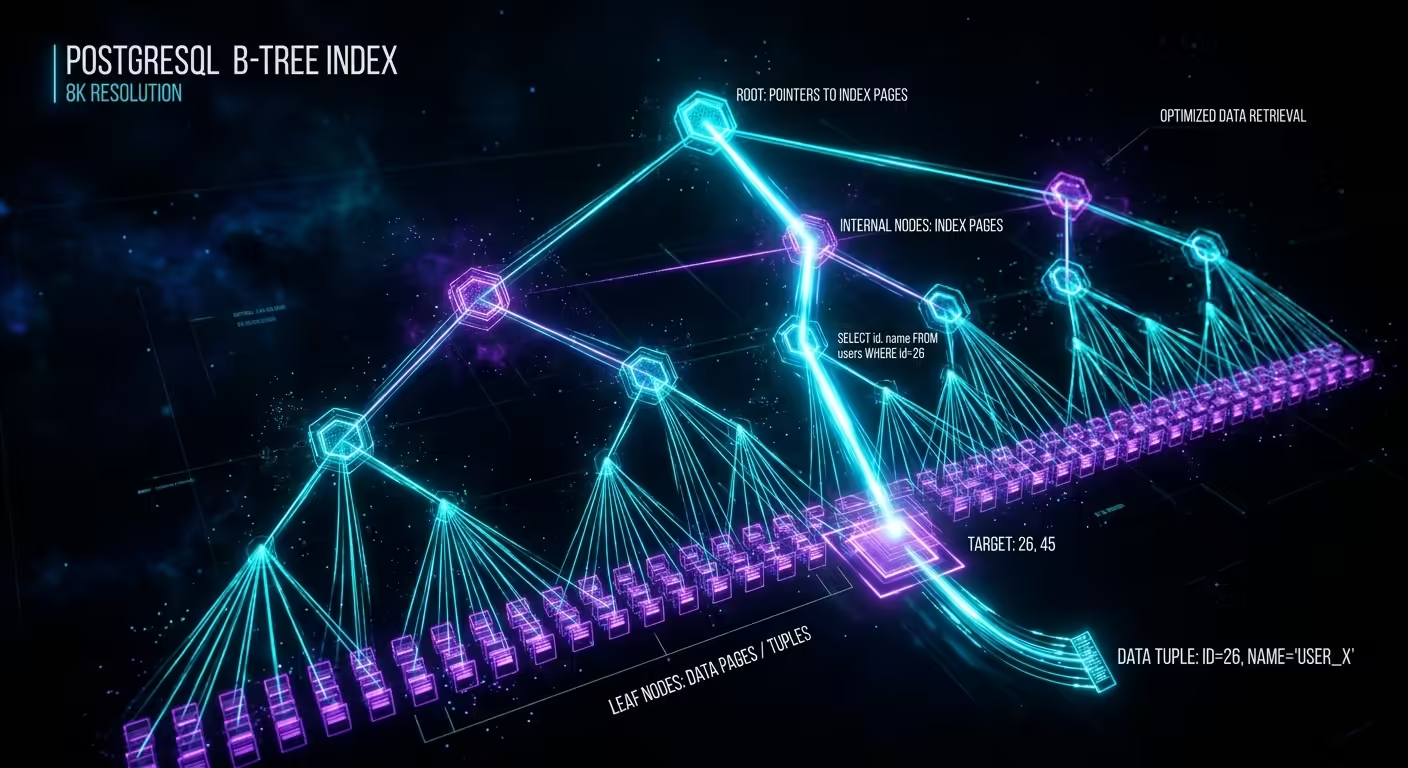
برای درک بهتر این موضوع، باید بدانیم پایگاه داده ساختار B-Tree را به صورت صفحات دیسک (Page) مدیریت میکند که برگهای درخت (Leaf Nodes) حاوی مقادیر واقعی ستونها به همراه آدرس دقیق رکورد در جدول اصلی هستند.
[ Root Node ]
       │
       ▼
[ Internal Node ]
       │
       ▼
[ Leaf Node ] ──> (Index Tuple: Key + Heap TID) ──> [ Table Row on Disk ]
هر گره در این ساختار از اجزایی به نام Index Tuple تشکیل شده است که نقش پل ارتباطی را میان دنیای ایندکس و دادههای اصلی جدول ایفا میکنند. ساختار فیزیکی یک Index Tuple شامل کلید ایندکس (مقدار ستون) و یک نشانگر فیزیکی به نام Heap TID است.
ارزیابی ساختار یک Index Tuple را میتوان با بررسی نحوه ذخیرهسازی آن در سیستم نشان داد:
SELECT ctid, * FROM users WHERE id = 10;
در این کوئری، مقدار ctid همان شناسه فیزیکی است که داخل Index Tuple به عنوان مقصد نهایی نگهداری میشود تا موتور دیتابیس بدون جستجوی اضافه، مستقیماً به صفحه و شماره اسلات رکورد روی دیسک برسد. شناسه ctid از دو بخش تشکیل شده است؛ شماره صفحه دیسک و شماره اسلات رکورد درون آن صفحه.
نکته کاربردی: دانستن این موضوع که Index Tuple همواره شامل کلید ایندکس و TID است، به ما کمک میکند بفهمیم چرا ایندکسهای معمولی مجبورند برای برداشتن ستونهای اضافی به جدول اصلی سر بزنند.
برای اینکه عمیقتر متوجه شویم این ساختار چطور عمل میکند، اجازه بدهید تفاوت ذخیرهسازی در گرههای میانی و برگ را بررسی کنیم:
- Internal Tuples: فقط حاوی مقادیر کلید برای مسیریابی در درخت و آدرس فرزندان هستند.
- Leaf Tuples: حاوی مقادیر نهایی کلید و شناسه
ctidبرای دسترسی مستقیم به جدول اصلی (Heap) هستند.
انتخاب نوع و تعداد ستونها در این ساختار تعیین میکند که آیا دیتابیس پس از یافتن Index Tuple نیازی به مراجعه مجدد به جدول دارد یا خیر. در بخشهای بعدی خواهیم دید که چطور با اضافه کردن ستونهای دلخواه به این ساختار، این رفتوآمدهای اضافی را به صفر برسانیم.
مکانیسم Index-Only Scan و تفاوت بنیادین آن با Index Scan
وقتی کوئریهای ما روی دیتابیسهای حجیم اجرا میشوند، بزرگترین گلوگاه عملکردی (Bottleneck)، عملیات خواندن دیسک است. اگر کوئری ما رکوردها را پیدا کند اما دیتابیس مجبور باشد برای هر سطر به جدول اصلی سر بزند، تعداد I/O دیسک دو برابر میشود و عملاً کارایی ایندکس زیر سوال میرود.
راهکار یک توسعهدهنده جونیور این است که تصور کند هر زمان ایندکسی روی ستونها وجود دارد، دیتابیس مستقیماً به سراغ فایل ایندکس میرود و کار تمام است. اما این تصور اشتباه باعث میشود دیتابیس در پشت صحنه همچنان درگیر خواندن صفحات داده (Heap Data Pages) جدول شود.
به عنوان مهندس نرمافزار، راهکار حرفهای ما استفاده از مکانیزم Index-Only Scan است. در این حالت، دیتابیس تمام ستونهای درخواستی کوئری را مستقیماً از ساختار خود ایندکس استخراج میکند و هیچ نیازی به مراجعه به جدول اصلی نخواهد داشت. این یعنی دستیابی به حداکثر توان عملیاتی (Throughput) و کاهش چشمگیر بار روی دیسک.
برای درک بهتر مسیر دادهها، جریان این دو مکانیزم را با هم مقایسه میکنیم:
-
مسیر Index Scan سنتی: کوئری ➔ جستجو در ایندکس ➔ دریافت شناسه
ctid➔ مراجعه به جدول اصلی (Heap) ➔ استخراج داده نهایی. -
مسیر Index-Only Scan: کوئری ➔ جستجو در ایندکس ➔ استخراج مستقیم مقادیر از گرههای برگ (Leaf Tuples) ➔ بازگرداندن پاسخ.
اما این انتخاب یک هزینه پنهان یا به اصطلاح Trade-off دارد. اگر نقشههای نگهداری دیداری دیتابیس (Visibility Map) بهروز نباشند یا تراکنشهای همزمان جدول را تغییر داده باشند، دیتابیس مجبور میشود برای بررسی اعتبار رکوردها باز هم به جدول سر بزند که به آن Overhead میگویند. زمانی که نرخ بهروزرسانی جدول (Write-heavy) بسیار بالا باشد، این مکانیزم کارایی خود را از دست میدهد و ایندکس اسکن معمولی ترجیح داده میشود.
بیایید اجرای یک کوئری را با دستور EXPLAIN ANALYZE بررسی کنیم تا تفاوت این دو دنیا را به چشم ببینیم. فرض کنید جدول کاربران را داریم و میخواهیم فقط ایمیلها را استخراج کنیم:
EXPLAIN ANALYZE
SELECT email FROM users WHERE id = 1500;
خروجی زیر نشان میدهد که دیتابیس چطور از ایندکس معمولی استفاده کرده اما هنوز درگیر جدول است:
Index Scan using users_pkey on users  (cost=0.42..8.44 rows=1 width=32) (actual time=0.015..0.016 rows=1 loops=1)
  Index Cond: (id = 1500)
Planning Time: 0.085 ms
Execution Time: 0.032 ms
حال اگر ساختار ایندکس ما طوری باشد که ستون مورد نظر را در خود جای دهد، خروجی به شکل زیر تغییر میکند:
Index Only Scan using users_email_idx on users  (cost=0.28..4.29 rows=1 width=32) (actual time=0.011..0.012 rows=1 loops=1)
  Index Cond: (id = 1500)
Heap Fetches: 0
Execution Time: 0.021 ms
يادآوری: مقدار Heap Fetches: 0 یعنی حتی یک بار هم به جدول اصلی مراجعه نشده است.
برای اینکه برنامهریز پستگرس (Query Planner) ترجیح دهد مسیر دوم را انتخاب کند، شرایط خاصی باید برقرار باشد. تمام ستونهایی که در دستور SELECT و WHERE فراخوانی میشوند باید به صورت کامل توسط ایندکس پوشش داده شوند.
نکته کاربردی: فیلد
Heap Fetchesدر خروجیEXPLAIN ANALYZEبهترین شاخص برای سنجش کارایی ایندکس است. اگر این عدد صفر باشد، یعنی Index-Only Scan با موفقیت کامل اجرا شده است. اگر این عدد بزرگ باشد، یعنی ویزیبیلیتی مپ نیاز بهVACUUMدارد یا ایندکس ستونهای کافی را پوشش نداده است.
در ادامه این آموزش بررسی میکنیم که چطور با اضافه کردن ستونهای کمکی به ساختار ایندکس، شرایط را برای این بهینهسازی حیاتی فراهم کنیم.
آشنایی با دستور کلیدی INCLUDE در دستورات CREATE INDEX
وقتی حجم جدول به دهها میلیون سطر میرسد، اضافه کردن ستونهای اضافی به ساختار ایندکس برای گرفتن خروجی Index-Only Scan باعث تورم شدید حجم ایندکس میشود. اگر یک توسعهدهنده بدون آگاهی از مکانیسم درونی پایگاه داده، تمام ستونهای مورد نیاز کوئری را به عنوان کلید اصلی ایندکس معرفی کند، درخت B-Tree سنگین میشود و کارایی عملیاتهای INSERT و UPDATE به شدت افت میکند.
راهکار یک توسعهدهنده جونیور این است که یک ایندکس مرکب (Multi-Column Index) بزرگ بسازد که تمام ستونهای شرط و ستونهای خروجی را به عنوان کلید مرتبسازی در بر بگیرد. این روش ساده به نظر میرسد اما تراکم ایندکس را به هم میزند، زیرا پایگاه داده مجبور است ستونهای پِیلود (Payload) را هم در فرآیند مقایسه و مرتبسازی درخت دخالت دهد که این کار فضای دیسک و حافظه پنهان را هدر میدهد.
انتخاب مهندسی در پلتفرم PostgreSQL استفاده از کلاوز قدرتمند INCLUDE است تا ستونهای کمکی صرفاً در گرههای برگی (Leaf Nodes) درخت ذخیره شوند و در کلیدهای مرتبسازی بالا دست دخالتی نداشته باشند. با این روش، ستونهای جستجو همچنان فشرده و سریع باقی میمانند، در حالی که کوئری ما به لطف حضور دادههای تکمیلی در برگها، بدون مراجعه به جدول اصلی اجرا میشود.
برای درک بهتر این ساختار، اجازه دهید به جریان داده در زمان اجرای کوئری نگاهی بیندازیم:
- جستجوی شرطی روی ستون کلید $\rightarrow$ عبور از گرههای میانی درخت B-Tree
- رسیدن به گره برگی (Leaf Node) $\rightarrow$ استخراج همزمان کلید و ستونهای ضمیمه شده با
INCLUDE - پایان عملیات $\rightarrow$ بازگرداندن نتیجه بدون نیاز به مراجعه به جداول Heap
در ادامه، نحوه پیادهسازی این ساختار را با یک مثال واقعی بررسی میکنیم. فرض کنید جدول کاربران داریم و میخواهیم جستجو روی ایمیل انجام دهیم اما تاریخ ثبتنام را هم بدون مراجعه به جدول اصلی نیاز داریم.
CREATE INDEX idx_users_email_inc
ON users (email)
INCLUDE (created_at);
در این دستور، ستون email به عنوان کلید اصلی مرتبسازی در درخت ثبت میشود، در حالی که ستون created_at به بخش دادههای برگی اضافه میگردد. اگر ساختار جدول تغییر کند و نیاز به افزودن ستونهای بیشتری داشته باشیم، روش کار به همین سادگی با توسعه لیست INCLUDE ادامه مییابد.
برای مقایسه دقیقتر، بگذارید دو رویکرد رایج را کنار هم قرار دهیم:
| ویژگی ساختاری | ایندکس مرکب سنتی | ایندکس با INCLUDE |
|---|---|---|
| مرتبسازی درخت | تمام ستونها درگیر مرتبسازی هستند | فقط ستونهای کلید مرتب میشوند |
| حجم فایل ایندکس | سنگین و مستعد تورم سریع | بهینه و متراکم |
| پشتیبانی از Index-Only Scan | دارد | دارد |
| سربار عملیات Write | بالا (به دلیل تغییرات کلیدها) | پایینتر (عدم تاثیر ستونهای ضمیمه بر ساختار کلید) |
اکنون بیایید سناریوی پیشرفتهتری را بررسی کنیم که در آن دو ستون ضمیمه برای پوشش کامل یک گزارش سریع نیاز داریم.
CREATE INDEX idx_orders_customer_inc
ON orders (customer_id)
INCLUDE (total_amount, status);
در این پیکربندی، ستون customer_id مسئولیت پیدا کردن سریع ردیفها را بر عهده دارد و مقادیر total_amount و status بدون اینکه در صف مقایسههای درختی قرار گیرند، آماده تحویل به کوئری هستند. این انتخاب باعث میشود حجم ایندکس روی دیسک به شکل محسوسی کوچکتر بماند و shared_buffers حافظه پنهان سرور با دادههای اضافی اشغال نشود.
نکته کاربردی: فراموش نکنید که ستونهای داخل کلاوز
INCLUDEهیچ نقشی در یکتایی (Uniqueness) یا شرطهای مرتبسازیORDER BYایندکس ندارند. اگر کوئری شما نیاز به مرتبسازی بر اساس ستون ضمیمه شده داشته باشد، پایگاه داده نمیتواند از این ایندکس برای مرتبسازی استفاده کند و این ساختار صرفاً برای پوشش دادن ستونهای انتخابیSELECTکاربرد دارد.
استفاده بهجا از این دستور به شما اجازه میدهد بدون قربانی کردن سرعت نوشتن دادهها، بالاترین بهرهوری را از خوانشهای سنگین پایگاه داده استخراج کنید.
نقش حیاتی Visibility Map در موفقیت Index-Only Scans
تا حالا برایتان پیش آمده که با وجود ساختن یک ایندکس کامل و بینقص، کوئریهای پرکاربردتان ناگهان شروع به انجام خوانشهای تصادفی و کند روی دیسک کنند؟ مشکل از ساختار ایندکس نیست، بلکه پایگاه داده برای اطمینان از اعتبار دادهها مجبور است به جدول اصلی سر بزند.
راهکاری که یک توسعهدهنده جونیور در مواجهه با این کندی امتحان میکند، اضافه کردن ایندکسهای بیشتر یا افزایش حافظه shared_buffers است. اما این رویکرد مشکل اصلی را حل نمیکند زیرا پایداری عملیات خوانش به این بستگی دارد که موتور پایگاه داده بداند آیا رکوردهای داخل ایندکس واقعاً معتبر و قابل استناد هستند یا خیر.
انتخاب مهندسی ما استفاده از سیستم Visibility Map یا همان VM است. این ساختار دادهای در پستگرس برای هر صفحه از جدول یک بیت اختصاص میدهد که مشخص میکند آیا تمام سطرهای آن صفحه برای همه تراکنشها قابل مشاهده هستند یا خیر. با این مکانیزم، موتور پایگاه داده بدون مراجعه به جدول اصلی میفهمد که نیازی به بررسی وضعیت تراکنشها (MVCC) ندارد.
| وضعیت بیت در VM | معنای سیستمی | رفتار پایگاه داده |
|---|---|---|
0 (False) |
نیازمند بررسی دقیق تراکنشها | مراجعه به جدول اصلی برای تست xmax و xmin |
1 (True) |
تضمین اعتبار تمام سطرها برای همه تراکنشها | انجام واقعی یک Index-Only Scan خالص و سریع |
توسعهدهندگان باید بدانند که اگر حجم عملیات UPDATE یا INSERT روی جدول بالا باشد، این بیتها به طور مداوم توسط فرآیند VACUUM پاکسازی و بازنشانی میشوند. اگر فرآیند autovacuum نتواند به موقع به جدول برسد، بیتهای Visibility Map صفر باقی میمانند و کارایی ایندکس افت شدیدی میکند.
نکته کاربردی: تصور نکنید ساخت ایندکس پوششی به تنهایی برای همیشه سرعت کوئریها را تضمین میکند. اگر آمار جدول قدیمی باشد یا فرآیند
autovacuumعقب بماند، موتور پایگاه داده قابلیت Index-Only Scan را کنار میگذارد و به سراغ Sequential Scan میرود.
برای بررسی وضعیت این ساختار روی یک جدول خاص، میتوانید از کوئری زیر استفاده کنید تا ببینید چه تعداد از صفحات جدول شما دارای بیتهای معتبر هستند:
SELECT
    relname,
    relpages,
    relallvisible
FROM pg_class
WHERE relname = 'users';
خروجی این دستور به شما نشان میدهد که چه حجمی از جدول توسط Visibility Map پوشش داده شده است:
relname | relpages | relallvisible
---------+----------+---------------
users | 125 | 120
جلوگیری از خوانشهای اضافی روی دیسک با استفاده از این بیتهای کنترلی محقق میشود.
در این بخش آموختیم که چگونه Visibility Map با ثبت وضعیت اعتبار سطرها، واسط میان ایندکس و جدول اصلی میشود تا موتور پایگاه داده بدون نیاز به مراجعه به دادههای اصلی، سریعترین پاسخ را ارائه دهد.
پیادهسازی عملی Covering Index روی جداول تراکنشی بزرگ
دانش تئوری در معماری پایگاه داده زمانی رنگ میبازد که یک کوئری پرکاربرد در ساعات اوج مصرف، جدول چند میلیون رکوردی سفارشها را قفل کند و سیستم با افت شدید عملکرد مواجه شود. در سیستمهای تراکنشی پرترافیک، مراجعه مکرر به جدول اصلی برای خواندن چند ستون معدود، بزرگترین گلوگاه I/O دیسک است که به شدت مقیاسپذیری سیستم را محدود میکند.
رویکرد تجربی یک توسعهدهنده مبتدی این است که برای هر ترکیب دلخواهی از ستونها در دستورات SELECT و WHERE، یک ایندکس ترکیبی مستقل بسازد تا سرعت پاسخدهی بالا برود. این روش به ظاهر سریع عمل میکند، اما با افزایش نرخ تراکنشها، فرآیند نوشتن (Write Amplification) به شدت کند میشود زیرا هر درج یا بهروزرسانی باید تکتک ایندکسها را همزمان بهروزرسانی کند. علاوه بر این، فضای ذخیرهسازی روی دیسک به سرعت هرز میرود و حافظه پنهان (Shared Buffers) با ایندکسهای غیرضروری پر میشود.
انتخاب مهندسی درست این است که به جای ایجاد ایندکسهای متعدد، از یک Covering Index مهندسیشده با کمک بند INCLUDE استفاده کنیم تا هم جستجو سریع بماند و هم سربار نگارش به حداقل برسد. این ساختار به موتور پایگاه داده اجازه میدهد ستونهای مورد نیاز کوئری را مستقیماً از درون ساختار درخت B-Tree استخراج کند و هیچ نیازی به مراجعه به جدول اصلی (Table Fetch) نداشته باشد.
نکته کاربردی: استفاده بیرویه از Covering Indexes روی جداول با نرخ درج و ویرایش (INSERT/UPDATE) بالا ممنوع است. هر ستونی که به بخش
INCLUDEاضافه میشود، حجم فایل ایندکس را افزایش میدهد و هزینه نگارش را بالا میبرد. تنها ستونهایی را اضافه کنید که در خروجی کوئریهای حیاتی و پرتردد حضور دارند.
برای درک بهتر، جدول سفارشهای یک سامانه فروشگاهی بزرگ را با میلیونها رکورد فرض کنید که کوئری زیر روی آن به طور مداوم اجرا میشود:
SELECT status, total_amount FROM orders WHERE customer_id = 10425;
اگر تنها یک ایندکس روی ستون customer_id داشته باشیم، موتور پایگاه داده پس از یافتن کلید در درخت ایندکس، ناچار است برای خواندن ستونهای status و total_amount به خود جدول مراجعه کند. حالا ساختار ایندکس پوششی را با هم پیادهسازی میکنیم:
CREATE INDEX idx_orders_customer_covering
ON orders (customer_id)
INCLUDE (status, total_amount);
در دستور بالا، ستون customer_id به عنوان کلید اصلی جستجو در ساختار درخت قرار میگیرد و ستونهای status و total_amount در برگهای ایندکس به صورت ضمیمه ذخیره میشوند. انتخاب customer_id به عنوان کلید جستجو به این دلیل است که شرط اصلی ما در بند WHERE روی این ستون اعمال میشود و تفکیک دادهها بر اساس آن انجام میگیرد.
بیایید خروجی تحلیل اجرای این کوئری را با دستور EXPLAIN ANALYZE بررسی کنیم تا تفاوت سیستماتیک آن را ببینیم:
Index Only Scan using idx_orders_customer_covering on orders  (cost=0.42..8.44 rows=1 width=13)
  Index Cond: (customer_id = 10425)
  Heap Fetches: 0
- Execution Time: 0.082 ms
مقدار Heap Fetches: 0 در خروجی بالا نشان میدهد که تمام اطلاعات مورد نیاز کوئری مستقیماً از روی ایندکس خوانده شده است و هیچ نیازی به دسترسی به بلوکهای جدول اصلی نبوده است. زمان اجرای کوئری به زیر یک میلیثانیه کاهش یافته و مصرف منابع I/O دیسک به صفر رسیده است.
در این بخش آموختیم که چگونه با طراحی دقیق Covering Index، دسترسیهای پر هزینه به جدول اصلی را حذف کنیم و کارایی کوئریهای تراکنشی را به شکل چشمگیری افزایش دهیم.
سنجش کارایی، تحلیل Bloat و مدیریت سربار نوشتن (Write Overhead)
بیملاحظه اضافه کردن ایندکسهای ترکیبی برای پوشش دادن هر کوئری جدیدی، سرعت خواندن را بالا میبرد اما پایگاه داده را در عملیاتهای نوشتن زمینگیر میکند و فضای دیسک را به سرعت میبلعد. وقتی تیمهای فنی بدون در نظر گرفتن هزینههای پنهان، برای هر گزارش جدید یک Covering Index میسازند، حجم جدول و شاخصهای آن به شدت رشد میکند و عملیاتهای INSERT و UPDATE با کندی مرگباری روبهرو میشوند. راهکار یک توسعهدهنده جونیور این است که هر زمان کوئری کند شد، یک ایندکس جدید بسازد، بدون اینکه به حجم فایلها یا تاثیر آن روی حافظه پنهان فکر کند. این رویکرد به مرور زمان باعث ایجاد تورم ساختاری یا همان Bloat در پایگاه داده میشود که در آن فضای خالی داخل ایندکسها مدیریت نمیشود و کارایی سیستم افت میکند. انتخاب مهندسی این است که بین سرعت خواندن و سربار نوشتن تعادل برقرار کنیم و با پایش مداوم حجم، نسبت تورم و هزینههای نگهداری، تصمیم بگیریم کدام ایندکس واقعاً ارزش هزینه کردن را دارد.
برای سنجش میزان تورم و بررسی اینکه آیا ایندکسهای ما فضای مرده زیادی مصرف میکنند یا خیر، از اکستنشن کاربردی pgstattuple کمک میگیریم. این ابزار وضعیت داخلی یک ایندکس را کالبدشکافی میکند و نشان میدهد چه مقدار از فضای دیسک واقعاً حاوی داده مفید است و چه بخشی به دلیل بهروزرسانیهای مکرر به هدر رفته است.
CREATE EXTENSION IF NOT EXISTS pgstattuple;

SELECT * FROM pgstattuple('idx_users_covering_status');
اجرای این کوئری خروجی دقیقی به ما میدهد که باید مقادیر آن را با دقت تحلیل کنیم تا وضعیت سلامت ایندکس مشخص شود.
-[ RECORD 1 ]------+----------------
table_len          | 16384
tuple_count        | 500
tuple_len          | 32400
tuple_percent      | 19.78
dead_tuple_count   | 420
dead_tuple_len     | 27300
dead_tuple_percent | 16.66
free_space         | 1024
free_percent       | 6.25
شاخص dead_tuple_percent در خروجی بالا نشان میدهد که چه درصدی از ایندکس به دلیل تغییرات رکوردهای جدول اصلی منسوخ شده اما هنوز فضا را اشغال کرده است. مقدار بالاتر از بیست درصد برای این فاکتور به این معنا است که ایندکس دچار تورم شده و پایگاه داده زمان زیادی را برای اسکن صفحات هرز هدر میدهد. در چنین شرایطی باید دستور REINDEX را اجرا کنیم تا ساختار ایندکس فشرده شده و کارایی بازیابی اطلاعات به حالت ایدهآل بازگردد.
نکته کاربردی: دستور
REINDEXروی ایندکسهای بزرگ میتواند جدول را قفل کند و دسترسی کاربران را مختل سازد؛ بنابراین همیشه از گزینهCONCURRENTLYاستفاده کنید تا عملیات بازسازی بدون قفل کردن جدول و در پسزمینه انجام شود.
برای بررسی دقیقتر هزینههای نگهداری و مقایسه تاثیر ایندکسها روی عملیاتهای نوشتن، از کوئری سیستماتیک زیر برای سنجش تعداد دفعات استفاده و میزان فضای اشغالشده بهره میگیریم.
SELECT
    indexrelname AS index_name,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size,
    idx_scan AS number_of_scans
FROM pg_stat_user_indexes
WHERE schemaname = 'public'
ORDER BY pg_relation_size(indexrelid) DESC;
در بررسی این آمار، اگر با ایندکسی مواجه شدیم که فضای زیادی اشغال کرده اما مقدار number_of_scans در آن نزدیک به صفر است، یعنی ایندکس مورد نظر هیچ کمکی به کوئریها نمیکند و فقط در حال تحمیل هزینه سربار نوشتن به سیستم است. مدیریت هوشمندانه پایگاه داده ایجاب میکند که اینگونه ایندکسهای بدون استفاده را شناسایی و حذف کنیم تا منابع سرور برای تراکنشهای اصلی آزاد شوند.
در این بخش آموختیم که چگونه با سنجش تورم، پایش فضای دیسک و تحلیل سربار نوشتن، توازن پایداری میان سرعت خواندن اطلاعات و کارایی عملیاتهای درج و ویرایش ایجاد کنیم.
الگوهای پیشرفته، تلههای رایج و چکلیست نهایی بهینهسازی
گاهی اوقات ساخت یک ایندکس پوششی بینقص به نظر میرسد، اما تغییرات ظریف در نوع داده یا استفاده از عبارتهای خاص باعث میشود موتور پایگاه داده قفل کند و به جای باز کردن مسیر سریع، دوباره سراغ اسکن سنگین جدول برود. بیتوجهی به این جزئیات پنهان میتواند تمامی تلاشهای بهینهسازی شما را در محیط عملیاتی بیثمر کند.
بیایید سناریویی را تصور کنیم که یک توسعهدهنده تازهکار با آن مواجه میشود. فرض کنید کوئری شما روی ستونی با نوع داده varchar جستجو میکند اما در تعریف ایندکس، نوع متفاوتی مانند text یا تطابقدهندههای متفاوتی (Collation) به کار رفته است. این ناسازگاری کوچک پنهان باعث میشود سیستم بستر ذخیرهسازی نتواند دادهها را مطابقت دهد و از قابلیت Index-Only Scan چشمپوشی کند.
مسیر دادهها در چنین شرایطی به این شکل تغییر میکند: درخواست کوئری ──> بررسی نوع داده و Collation ──> عدم تطابق دقیق ──> پرش از ایندکس و اجرای Sequential Scan پرهزینه.
برای حل این چالش در سطوح پیشرفته، استفاده از Expression Indexes به همراه ستونهای ضمیمه اهمیت پیدا میکند. اگر بخواهیم روی خروجی یک تابع مثل تبدیل حروف کوچک و بزرگ جستجو کنیم و همزمان اطلاعات دیگری را هم پوشش دهیم، باید عبارت محاسباتی را دقیقاً در ساختار ایندکس لحاظ کنیم.
CREATE INDEX idx_users_lower_email
ON users (LOWER(email))
INCLUDE (first_name, last_name);
در قطعه کد بالا، عبارت (LOWER(email)) به عنوان کلید اصلی ایندکس عمل میکند زیرا کوئریهای ما دقیقاً همین تبدیل را روی ایمیل انجام میدهند. ستونهای first_name و last_name در بخش INCLUDE قرار میگیرند تا بدون شرکت در درخت جستجوی اصلی، دادههای مورد نیاز را پوشش دهند. انتخاب این ساختار زمانی الزامی است که جستجوهای متنی حساس به حروف بزرگ و کوچک نداریم و میخواهیم سرعت خروجی را به حداکثر برسانیم.
گاهی اوقات حجم جدول بسیار بزرگ است و تمام رکوردهای آن برای ما اهمیت ندارند، مثلاً کاربران غیرفعال یا حذفشده. در این حالت ساخت یک ایندکس کامل هزینه بیهودهای روی دیسک تحمیل میکند. راهکار حرفهای استفاده از Partial Covering Indexes است.
CREATE INDEX idx_active_users_summary
ON users (id)
WHERE status = 'active';
در این مثال، عبارت WHERE status = 'active' باعث میشود تنها سطرهایی که وضعیت فعال دارند در ایندکس ذخیره شوند. این انتخاب هوشمندانه حجم ایندکس را به شدت کاهش میدهد و حافظه پنهان سرور (RAM Cache) را بهینهتر مصرف میکند. اگر شرط کوئری شما همیشه شامل status = 'active' باشد، این ایندکس معجزه میکند.
نکته کاربردی: مراقب مقادیر
NULLدر ستونهای پوششدادهشده باشید. اگر ستونهای موجود در بخشINCLUDEحاوی مقادیر تهی زیادی باشند، فضای ذخیرهسازی ایندکس به طور چشمگیری افزایش مییابد بدون اینکه کارایی واقعی داشته باشد.
برای اینکه مطمئن شویم ساختار پایگاه داده در شرایط تولید کاملاً آماده است، بررسی این چکلیست نهایی پیش از انتشار الزامی است:
| گام ارزیابی | وضعیت مطلوب | پیامد بیتوجهی |
|---|---|---|
| تطابق نوع داده | یکسان بودن دقیق نوع ستون و ایندکس | افتادن در دام Sequential Scan پنهان |
| پایش حجم ایندکس | کمتر یا مساوی با اندازه جدول مربوطه | هدررفت حافظه RAM و کندی عملیات Write |
| تحلیل EXPLAIN | مشاهده عبارت Index Only Scan |
عدم استفاده واقعی از ستونهای پوششی |
| مدیریت Bloat | اجرای منظم دستورات نگهداری و بازسازی | تکهتکه شدن فضا و کاهش سرعت پیمایش |
در نهایت، تسلط بر ساختار ایندکسهای پوششی به شما اجازه میدهد گلوگاههای بحرانی خواندن اطلاعات را بدون دستکاری ساختار اصلی جدول برطرف کنید. با اجرای دقیق این الگوها، پایگاه داده شما با کمترین میزان مصرف منابع، پاسخگوی سنگینترین ترافیکها خواهد بود.